 PLAY AI 筆記
自架開源模型看起來省錢,但我會先算哪些隱藏成本:重點與影響整理
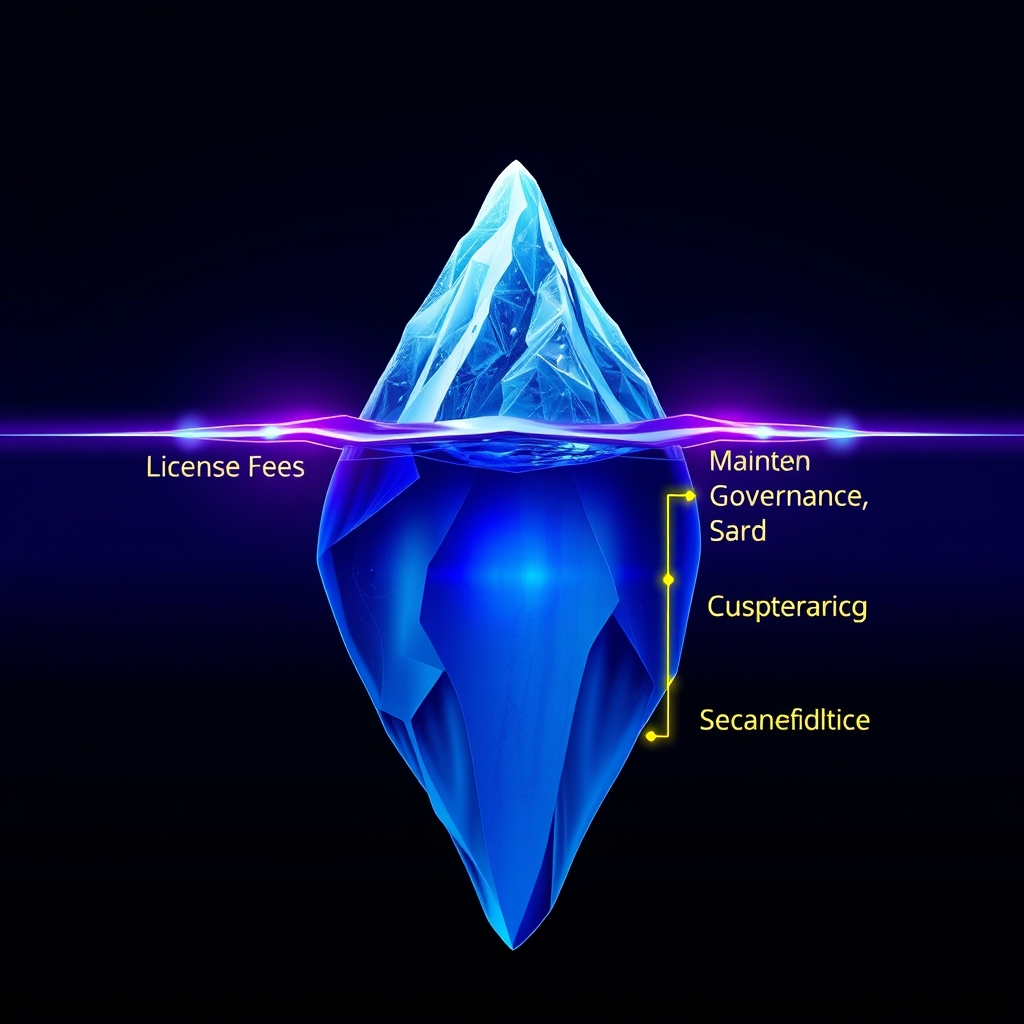
開源模型的隱性成本主要集中在導入後的維運、治理與風險控管,而非模型本身的授權費用。 企業在導入開源模型時,需自行承擔資料清洗、提示詞治理、輸出審查、權限控管與版本回溯等工作。
本篇內容
這次發佈的核心重點
開源模型的隱性成本主要集中在導入後的維運、治理與風險控管,而非模型本身的授權費用。 判斷開源模型是否划算應考量長期可控性與替代彈性,而非僅看短期費用。 DeepSeek 的 API 價格極具競爭力,其每百萬 token 輸出價格約為 0.87 美元。[3][4]
能力、定位與實際意義
企業在導入開源模型時,需自行承擔資料清洗、提示詞治理、輸出審查、權限控管與版本回溯等工作。 降低開源模型隱性成本的策略包括建立模型驗證、版本管理、權限控管與備援機制。 DeepSeek 的資金來源與結構與傳統新創不同,其背後由對沖基金幻方量化提供持續的現金流支持。[3][4]
缺乏成熟的 MLOps、資安與法遵流程,會導致企業將原本由供應商承擔的責任轉回內部,增加人力、時間與協作成本。 Hugging Face 平台擁有超過 1800 萬名用戶,並共享逾 300 萬個模型與 50 萬個資料集。 智譜 AI 在 2025 財年前,有超過七成的營收來自中國地方政府與國企的私有化部署專案。[3][4]
限制與需要留意的地方
若模型社群更新節奏不穩或文件不完整,企業需承擔額外的測試與替換成本。 歐盟客戶對中國模型的合規疑慮主要集中在:無法交代訓練數據的版權來源,以及無法證明用戶數據不會流向中國境內伺服器。 阿里巴巴 Qwen 3.5、3.6 系列模型的參數範圍涵蓋從 0.8B 到 397B。[3][4]
接下來值得觀察什麼
在金融、醫療或客服等高敏感場景應用開源模型時,錯誤輸出的責任歸屬與審計需求會放大隱性成本。 阿里巴巴透過開源 Qwen 系列模型(如 Qwen 3.5、3.6)作為流量入口,旨在將企業導向其阿里雲託管服務以獲取雲端算力收益。 目前來源顯示,使用中國開源模型可能導致在進入歐美市場時面臨法務盡職調查(Due Diligence)的合規風險。[3][4]
資料來源與延伸閱讀
以下來源用於核對本文的技術背景與關鍵事實;正文中的編號可直接跳到對應來源。產品規格與時效性資訊仍以原始官方頁面最新版本為準。
查看 9 個來源
- US10095217B2 - Natural language user interface for computer-aided design systems - Google Patents
- EP316. Claude 3.5 Sonnet, Meta to Sell Compute, PLTR Partners with NVDA | M View
- 開源模型的隱性成本有哪些?
- 免費的模型最貴:中國 AI 開源背後的資本局,跟你遲早要付的合規帳|無名小卒的胡思亂想
- 自己部署 AI,真的比較便宜嗎? 從開源模型、GPU 到商業成本一次搞懂 - YouTube
- AI Industry Research: Data, Tools & Market Analysis Guide
- 瑞银发现:60%已开始控制AI支出,企业转向低成本模型与 ...
- Cordis \u5fae\u5167\u6838\uff1a\u53ea\u7ba1\u7406\u751f\u547d\u9031\u671f\u7684\u6838\u5fc3<\/h3>\n
- \u793e\u7fa4\u53cd\u61c9\uff1a\u8208\u596e\u8207\u8cea\u7591\u4e26\u5b58